Se puede monitorizar mediante SNMP el estado de los diferentes servidores y servicios que componen el sistema Perform.

Comandos para incluir en el fichero /etc/nagios-plugins/config/snmp.cfg
# Monitorización de Avaya Definity a través del servicio SNMP v2c
#Asier López Vega 2006
# check_avaya_status; chequea el estado de ejecuacion de la centralita 5 es OK
define command{
command_name check_avaya_status
command_line /usr/lib/nagios/plugins/check_snmp -H $HOSTADDRESS$ -t 60 -C public -o .1.3.6.1.4.1.6889.2.8.1.1.1.0 -c 5 -P 2c -l "Estado" -w 4:1 -c 7:6
}
#check_avaya_hw_health_power; chequea el estado electrico, si la alimentacion es Comerial o Backup
define command{
command_name check_avaya_hw_health_power
command_line /usr/lib/nagios/plugins/check_snmp -H $HOSTADDRESS$ -t 60 -o .1.3.6.1.4.1.6889.2.8.1.6.19.0 -C public -P 2c -r comm -l 'Tipo' -u 'Commercial or Backup'
}
# check_avaya_mayor_alarms; chequea el numero de Alarmas Mayor
define command{
command_name check_avaya_mayor_alarms
command_line /usr/lib/nagios/plugins/check_snmp -H $HOSTADDRESS$ -t 60 -o .1.3.6.1.4.1.6889.2.8.1.6.5.0 -C public -P 2c -c 0 -l 'Mayor' -u 'alarmas'
}
# check_avaya_minor_alarms; chequea el numero de Alarmas Minor
define command{
command_name check_avaya_minor_alarms
command_line /usr/lib/nagios/plugins/check_snmp -H $HOSTADDRESS$ -t 60 -o .1.3.6.1.4.1.6889.2.8.1.6.6.0 -C public -P 2c -c 0 -l 'Minor' -u 'alarmas'
}
#check_avaya_warning_alarms; chequea el numero de Warninigs
define command{
command_name check_avaya_warning_alarms
command_line /usr/lib/nagios/plugins/check_snmp -H $HOSTADDRESS$ -t 60 -o .1.3.6.1.4.1.6889.2.8.1.6.7.0 -C public -P 2c -w 1 -l ' ' -u 'alarmas'
}
#check_avaya_active_ip; muestra la IP del servidor activo
define command{
command_name check_avaya_active_ip
command_line /usr/lib/nagios/plugins/check_snmp -H $HOSTADDRESS$ -t 60 -o .1.3.6.1.4.1.6889.2.8.2.2.10.0 -C public -P 2c -l IP
}
#check_avaya_hw_server_type; muestra el tipo de HW
define command{
command_name check_avaya_hw_server_type
command_line /usr/lib/nagios/plugins/check_snmp -H $HOSTADDRESS$ -t 60 -o .1.3.6.1.4.1.6889.2.8.2.2.20.0 -C public -P 2c -l Tipo
}
#check_avaya_CPU_HP; muestra el consumo de CPU de los procesos de alta prioridad
define command{
command_name check_avaya_CPU_HP
command_line /usr/lib/nagios/plugins/check_snmp -H $HOSTADDRESS$ -t 60 -o .1.3.6.1.4.1.6889.2.8.1.6.11.0 -C public -P 2c -l 'Uso CPU (Hight priority services)' -u '%'
}
#check_avaya_CPU_CP; cosumo de CPU del Call procesing
define command{
command_name check_avaya_CPU_CP
command_line /usr/lib/nagios/plugins/check_snmp -H $HOSTADDRESS$ -t 60 -o .1.3.6.1.4.1.6889.2.8.1.6.12.0 -C public -P 2c -l 'Uso CPU (Call Procesing)' -u '%'
}
# check_avaya_CPU_SM; consumo del CPU de los procesos del sistema
define command{
command_name check_avaya_CPU_SM
command_line /usr/lib/nagios/plugins/check_snmp -H $HOSTADDRESS$ -t 60 -o .1.3.6.1.4.1.6889.2.8.1.6.13.0 -C public -P 2c -l 'Uso CPU (System Magnamet)' -u '%'
}
#check_avaya_CPU_F; % de CPU libre
define command{
command_name check_avaya_CPU_F
command_line /usr/lib/nagios/plugins/check_snmp -H $HOSTADDRESS$ -t 60 -o .1.3.6.1.4.1.6889.2.8.1.6.14.0 -C public -P 2c -l 'Uso CPU (Libre)' -u '%'
}
# check_avaya_status_trunk; chequea el estado del troncal numero $ARG1$ que le pasemos
define command{
command_name check_avaya_status_trunk
command_line /usr/lib/nagios/plugins/check_snmp -H $HOSTADDRESS$ -t 60 -o .1.3.6.1.4.1.6889.2.8.1.32.6.1.3.$ARG1$,.1.3.6.1.4.1.6889.2.8.1.53.6.1.7.$ARG1$,.1.3.6.1.4.1.6889.2.8.1.53.6.1.16.$ARG1$ -C public -P 2c -w ,,0:0 -c ,,0:0 -u '->',' total','fuera de servicio' -l 'Status Trunk'
}
# check_avaya_status_medpro; chequea el estado de la tarjeta $ARG1$ que le pasemios
define command{
command_name check_avaya_status_medpro
command_line /usr/lib/nagios/plugins/check_snmp -H $HOSTADDRESS$ -t 60 -o 1.3.6.1.4.1.6889.2.8.1.132.6.1.3.$ARG1$,1.3.6.1.4.1.6889.2.8.1.132.6.1.4.$ARG1$,1.3.6.1.4.1.6889.2.8.1.132.6.1.8.$ARG1$,1.3.6.1.4.1.6889.2.8.1.132.6.1.33.$ARG1$ -C public -P 2c -w ,,,0:0 -c ,,,0:0 -u 'IP',' Ethernet Enable','Criticals' -l 'IP-MedPro'
}
#check_avaya_all_completed_calls_in_hour; llamadas completadas en la ultima hora
define command{
command_name check_avaya_all_completed_calls_in_hour
command_line /usr/lib/nagios/plugins/check_snmp -H $HOSTADDRESS$ -t 60 -o 1.3.6.1.4.1.6889.2.8.1.111.10.0 -C public -P 2c -w 400000:200001 -c 200000:100000 -u 'Llamadas completadas hora actual' -l 'TOTAL'
}

Después de configurar el cluster para el servicio de proxy surge la inevitable necesidad de monitorizar su funcionamiento.
Nagios es un excelente software de monitorización y testeo de disponibilidad de servicios, yo incluso he logrado monitorizar una centralita Avaya con este software, y el cluster heartbeat también es posible monitorizarlo, en este post voy a explicar como chequeo el estado del servicio de proxy y la disponibilidad de cada uno de sus miembros.
Hay muchos manuales para instalar Nagios, por lo que paso directamente al tema; lo primero es monitorizar la disponibilidad del servicio que estamos ofreciendo, en este caso de proxy, independientemente del estado de los miembros del cluster;
En el directorio NAGIOS:/etc/nagios2/conf.d#
# Definimos el Host de nuestro cluster y definimos los miembros
define host {
host_name proxy.dominio.local
alias vIP Cluster Proxy
address 192.168.1.100
use generic-host
}
define host {
host_name A4
alias Proxy A1
address 192.168.1.101
use generic-host
}
define host {
host_name A5
alias Proxy A2
address 192.168.1.102
use generic-host
}
define host {
host_name A6
alias Proxy A3
address 192.168.1.103
use generic-host
}
#Definimos el hostgroup para chequear servicios
# Proxys
define hostgroup {
hostgroup_name PROXY-CLUSTER
alias PROXY-CLUSTER
members proxy.dominio.local,A1,A2,A3
}
# Definimos el servicio para el grupo
define service{
hostgroup_name PROXY-CLUSTER
service_description PROXY-CLUSTER
check_command check_squid
use generic-service
}
Hay que tener en cuenta que la definición de comando de servicio este correcta en /etc/nagios-plugins/config/http.cfg deberiamos de tener una linea como la siguiente
# 'check_squid' command definition
define command{
command_name check_squid
command_line /usr/lib/nagios/plugins/check_http -H $HOSTADDRESS$ -p 3128 -u http://www.google.es -e 'HTTP/1.0 200 OK'
}
Yo compruebo que este disponible google.es pero se puede utilizar cualquier URL.
Con esto ya tendriamos resultados a cerca del estado del servicio, pero no sabriamos si un miembro del cluster ha caído, para ello se puede hacer algo simple como un ping (o en Nagios un Check_host_alive) pero así solo tendríamos la disponibilidad del host, no la del servicio proxy y mucho menos si para el cluster el miembro sigue presente.
Utilizo un pluggin de Nagios llamado check_heartbeat_link descargable aquí, con este pluggin podemos consultar en cada miembro del cluster como esta viendo al resto de los miembros, este pluggin hay que ejecutarlo mediante NRPE (nagios remote pluggin execute) aquí hay un manual para configurarlo.
define service{
use generic-service
host_name A1
service_description Heartbeat
check_command check-nrpe-heartbeat
}
define service{
use generic-service
host_name A2
service_description Heartbeat
check_command check-nrpe-heartbeat
}
define service{
use generic-service
host_name A3
service_description Heartbeat
check_command check-nrpe-heartbeat
}
El resultado, mas un par de cosas interesantes a chequear debería de ser el siguiente;

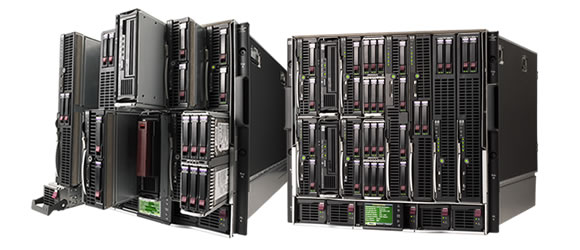 |
| Chasis HP c7000 |
Cada vez es más común ver CPD's llenos de chasis


